
AI破解覆膜过程的"三体问题"
近日,实验室低碳工业过程与智能计算研究团队(LCP-IC)在液滴覆膜智能控制领域取得重要进展。论文第一作者为博士生李子丰,通讯作者为管小平副研究员与杨宁研究员,合作者包括许秋石副研究员和郭强研究员。该研究得到中国科学院"智能化工"战略性先导科技专项(XDA0490102)和国家自然科学基金等项目的支持。成果发表于化工领域重要期刊《Chemical Engineering Science》(CES 331, 2026, 123973)。该研究首次将深度强化学习与VOF界面模拟闭环耦合,让AI在三颗粒体系中自主学会了均匀覆膜的控制策略,并揭示了"介尺度局部非均匀是实现全局均匀的必由之路"这一深刻原理。
一个"三体问题"式的挑战
液滴覆膜是喷雾造粒、药物包衣、催化剂制备等众多工业过程的核心环节。然而,要让多个颗粒表面的液膜分布均匀,却极其困难——液滴撞击后的铺展、回弹、破碎具有强非线性和随机性,不同颗粒因几何位置差异往往"旱涝不均",出现局部过湿或覆膜不足。
这一困境与天体力学中著名的"三体问题"异曲同工。所谓"三体问题",是指预测三个在相互引力作用下运动的天体轨迹的经典难题:早在1887年,庞加莱就证明了它不存在一般性的解析解——三个天体的运动方程看似简单,却无法写出长期演化的确定答案。更深刻的性质在于,三体系统是一个典型的混沌系统:它对微扰极度敏感,初始条件的毫厘之差会在演化中被不断放大,最终导向完全不同的运动结局,正所谓"差之毫厘,谬以千里"。正因如此,"三体问题"成为混沌与不可预测性的代名词。多颗粒覆膜体系与之神似:液滴在颗粒间的铺展、渗透与分配同样由多体相互作用支配,喷射速度、液滴半径等参数的微小扰动,都可能导致液膜分布的显著差异——这正是多颗粒均匀覆膜长期难以控制的根源。
研究团队选择了一个看似简单却极具代表性的场景:三个颗粒同步覆膜。为什么是三个?因为这是复杂颗粒堆积体系的最小拓扑单元——它包含多体相互作用(三角形间隙通道、上下颗粒位置差异、液体竞争分配),比两颗粒体系更丰富,又比大量颗粒体系更可控。正如天体力学中著名的"三体问题",简单到可以描述,却复杂到能涌现混沌与智能行为,因而成为检验智能控制策略的理想试验台。
图1. 科幻巨著《三体》:天体力学中著名的"三体问题"正是本研究三颗粒覆膜构型的灵感类比——简单到可以描述,却复杂到能涌现混沌。(图片来源于网络)
AI如何学会"分配液体"?
研究团队构建了一个闭环框架:VOF界面模拟作为"环境",DSAC(分布式柔性演员评论家)算法作为"大脑"。AI通过33个CFD探针感知流场,实时调节液滴的喷射速度与半径两个动作,目标是在160个控制步内让三个颗粒的覆膜既均匀、覆盖率又高。
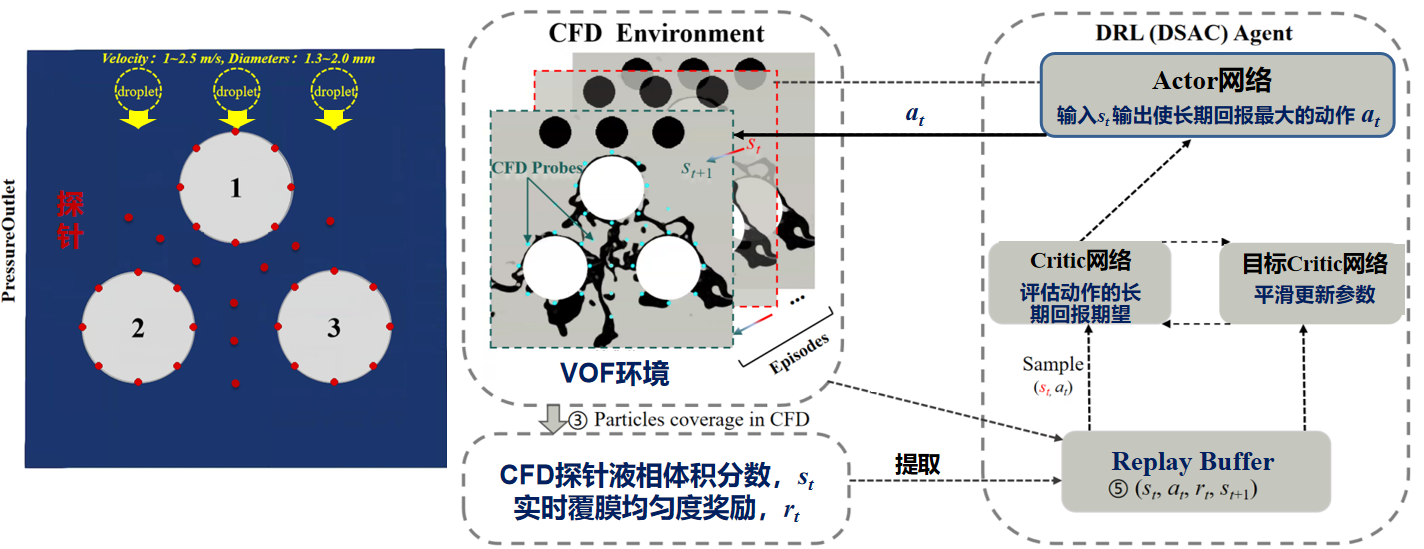
图2. VOF-DSAC闭环智能控制框架示意图:智能体读取液体体积分数探针信号并输出注射速度与液滴半径,形成”环境模拟—状态感知—动作决策—策略更新”的循环。
结果令人惊喜:
发现一:AI自主学会了"拮抗耦合"策略。喷射速度与液滴半径并非独立变化,而是"此消彼长"地联动调节——速度增大时半径减小,反之亦然。其物理本质是将韦伯数稳定在约115的最优区间。韦伯数是流体力学中决定液滴铺展与回弹的核心无量纲数:太低则铺展不足,太高则飞溅破碎。AI通过两个动作的互补调节,恰好把韦伯数锁定在"铺展充分但不破碎"的黄金区间。
发现二:AI学会了"看几何下菜"。当颗粒排列紧凑、间隙狭窄时,AI采用"高动量+限量供液"策略增强渗透;当颗粒分散时,则交替使用协同与拮抗模式。这种自适应能力,是任何固定策略都无法企及的。
发现三:AI揭示了“此消彼长”的“介尺度”竞争分配机制。对覆盖率增量(ΔC)的介尺度分析发现,AI并不追求每一步都均匀分配液体,而是通过时间域上的交替偏置——一个颗粒多得了,另一个就少得One gains,others lose——在统计意义上实现全局均匀。
这一发现揭示了一个深刻原理:介尺度局部非均匀是实现全局均匀的必由之路。
Local non-uniformity at the mesoscale is the necessary route to global uniformity.
性能有多强?
与五种代表性固定策略(FP1-FP5)和PPO算法相比,DSAC表现全面胜出:
DSAC学习速度更快(得益于经验回放,早期探索效率远高于PPO强化学习框架);同时强化学习智能体学习到的策略能够实现三颗粒覆盖率的同步演化——三条覆盖率曲线紧密耦合、同步波动,这是固定策略完全做不到的。
研究还发现,最优固定策略(FP1)恰好位于参数空间中心,而非边界。这说明:最优操作不是极端参数,而是平衡参数——但即便如此,固定策略也无法突破其"刚性"天花板,只有动态调节才能达到真正的均匀。
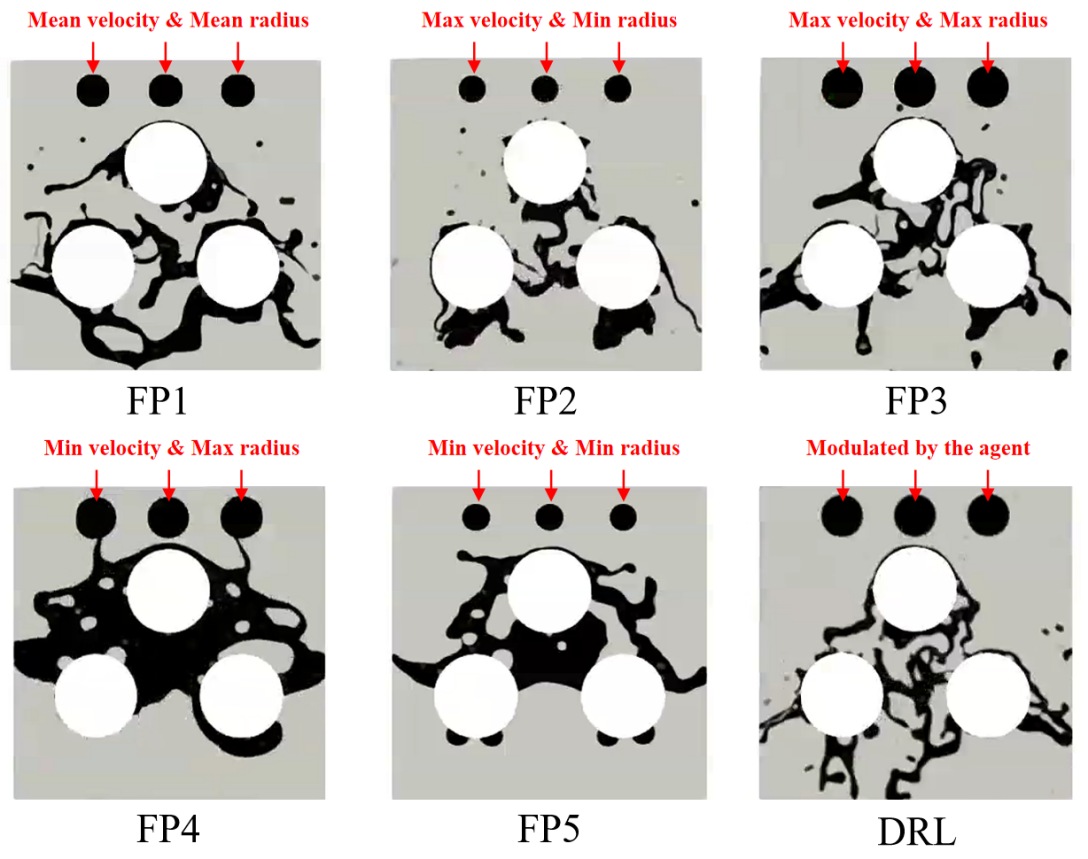
图3. 控制末步的液相分布对比:五种固定策略(FP1-FP5)与DRL智能调控。
研究意义与价值
科学层面,该研究揭示了液滴覆膜过程中"拮抗耦合稳定韦伯数"与"时间域交替分配实现全局均匀"两条物理机制,为理解多颗粒覆膜动力学提供了新视角。
方法层面,这是VOF与深度强化学习闭环耦合在多颗粒覆膜场景中的首次成功验证,展示了DRL在复杂界面演化问题中发现可解释控制策略的能力。
工程层面,该研究给出了一条可直接移植的操作原则:雾化压力与液滴粒径应联动调节以锁定目标韦伯数,而非各自独立设定。这为喷雾造粒、药物包衣等过程的参数设计提供了新思路。
论文信息
论文:Li Z, Xu Q, Guo Q, Guan X, Yang N. Towards intelligent droplet coating for particles: A CFD-integrated deep-reinforcement-learning control approach. Chemical Engineering Science, 2026, 331: 123973.


